最近挖到个叫 VoiceStudio 的开源神器,感觉像是给普通人的声音工厂装上了核动力引擎。以前搞配音或者做视频本地化,得把各种软件拼凑在一起,现在它直接把 TTS 合成和 ASR 识别全塞进去了,最绝的是那些引擎能一键切换,就像在厨房随手换锅炒菜,想追求极致效果还是图个快,随你心意。我试过它的零样本克隆功能,真的只要扔进去三到十五秒的录音,它就能把那个人的语气、甚至那种特有的小毛病都学得像模像样,不用去网上找那些花里胡哨的模型文件了。更有趣的是,你根本不需要提供声音样本,直接告诉它“我要一个三十岁带点伦敦腔、说话有点慵懒的女声”,它就能凭空捏造出来,这简直是把想象力变成了现实。对于想做有声书或者多角色对话的朋友来说,它能自动区分不同说话人并生成字幕,甚至还能把长篇 EPUB 文件直接变成章节分明的音频,这种一站式搞定全流程的能力,确实让原本需要专业团队的工作变得一个人也能轻松驾驭。不过看它的更新日志,技术党可能会觉得有点“硬核”,比如 Linux 启动器现在能提前发现缺失的插件防止崩溃,还有那些关于 Rust 回环和 Docker 服务的描述,听着像是在给服务器做体检。但在我看来,这些底层优化其实是为了让上面的创意功能跑得更稳,毕竟谁也不想因为软件闪退而打断创作灵感。它把复杂的音频处理逻辑藏在了简单的按钮后面,既保留了专业级的精细控制,比如逐行编辑字幕时间线,又给了小白用户“描述声音”这种低门槛的入口,这种平衡感在现在的 AI 工具里真的不多见。
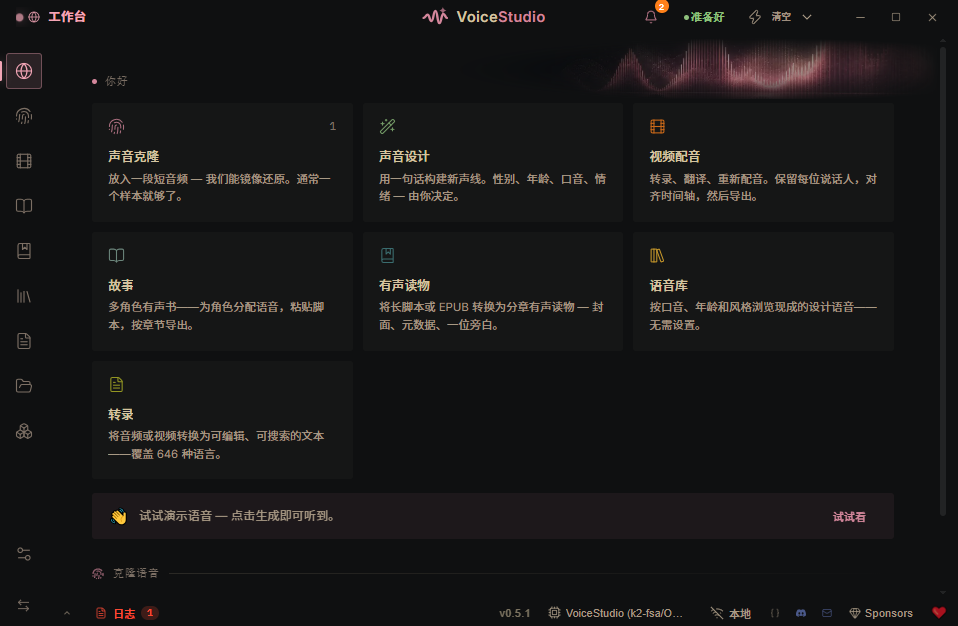
软件特色
1、声音克隆
放一段短片——我们会镜像它。通常三秒钟就够了。
2、声音设计
从一句话中构建新的声音。性别、年龄、口音、音调、情感。
3、视频配音
转录、翻译、重新配音。保留每个扬声器并对齐时间。
4、故事
多声部有声书——选角,放入剧本。
5、有声书
把长篇剧本或EPUB改编成有章节的有声书。
6、配音画廊
浏览按口音、年龄和风格设计的现成声音。
7、文字记录
将音频或视频转换为可编辑、可搜索的文本。
VoiceStudio电脑版如何设计新声音
1、打开VoiceStudio电脑版,进入【语音】界面;
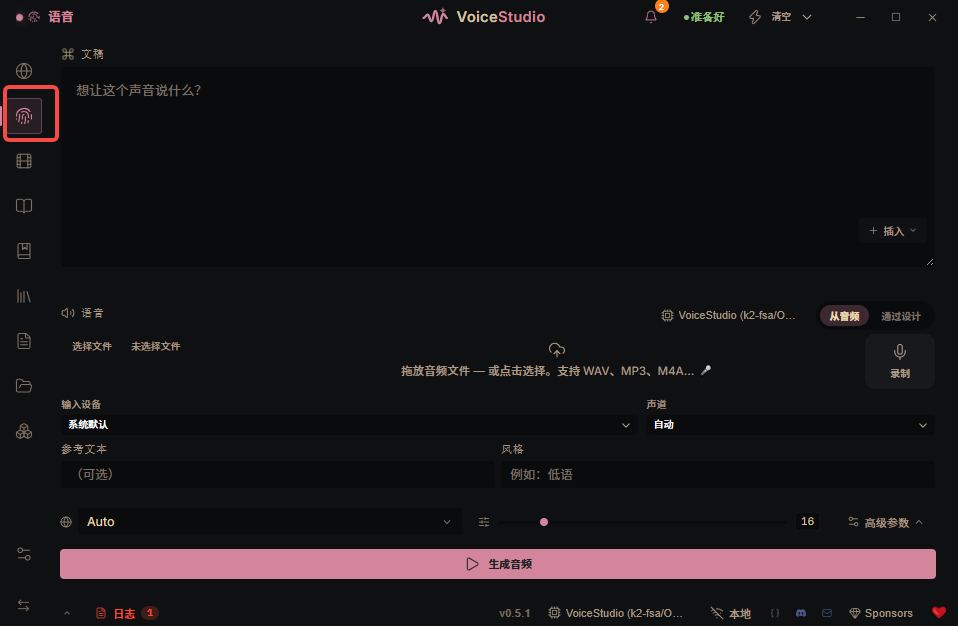
2、在输入框中输入声音要说的文本;
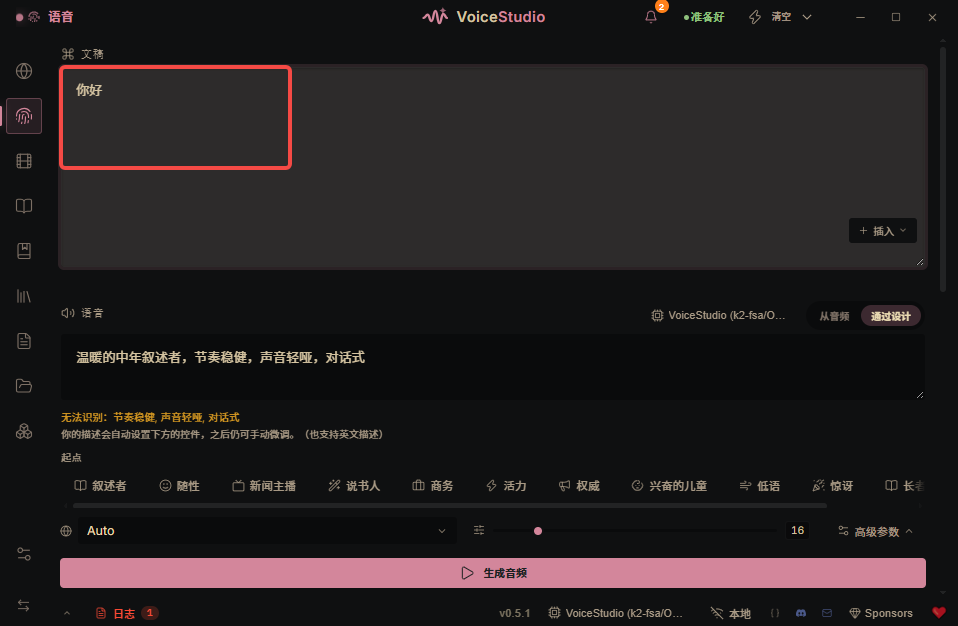
3、选择一个预设或使用“描述你的声音”,写出可观察的特征,如 年龄范围、声带、速度、口音、能量和表达情境;
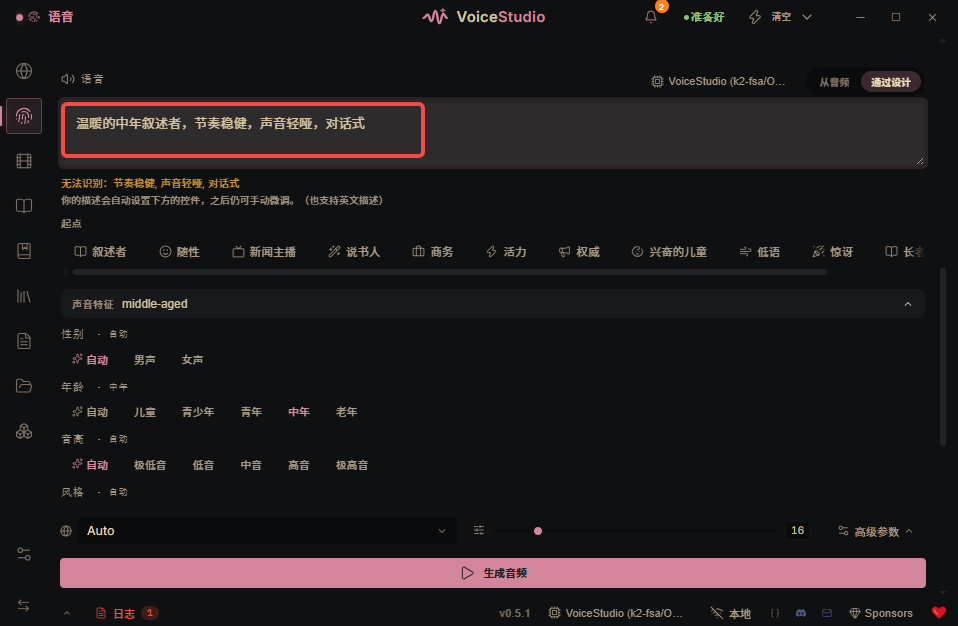
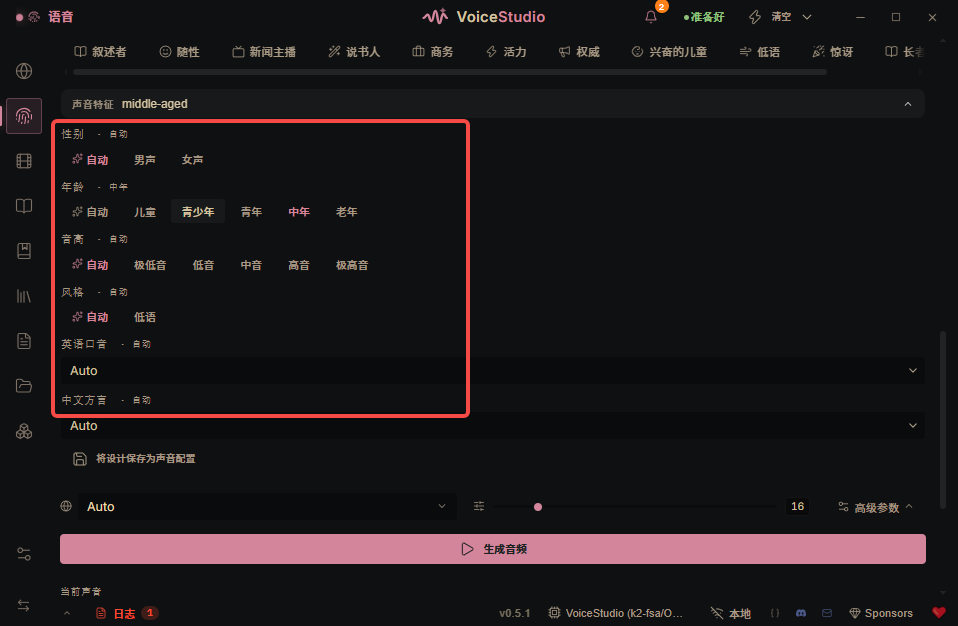
4、我们可以进一步细化声音设置;
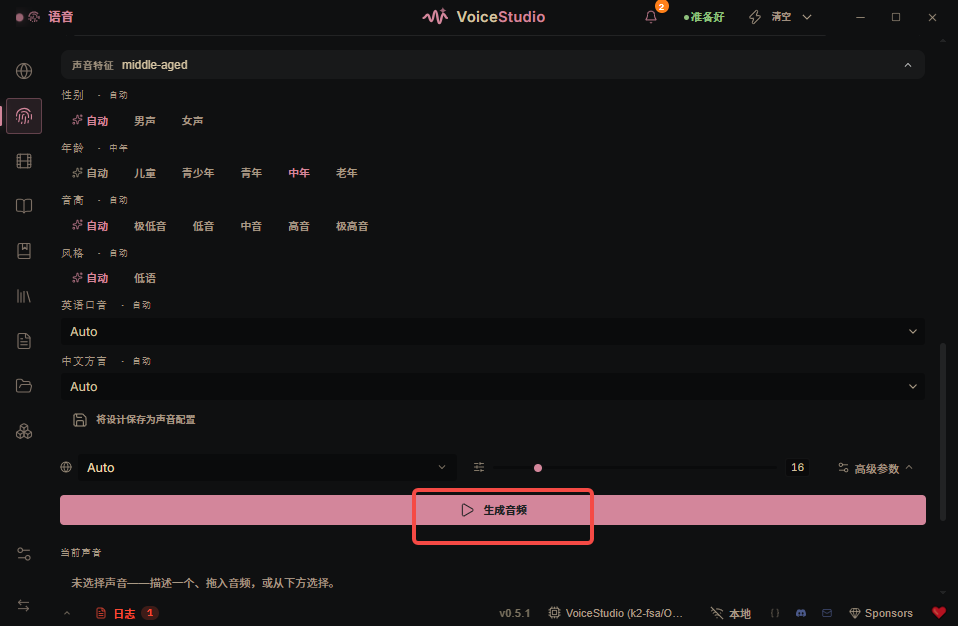
5、最后选择【生成音频】即可;
6、以上就是VoiceStudio电脑版设计新声音的操作教程。
更新日志
v0.5.1版本
1、Model Catalogue 现在使用一个通风的办公区画布,采用更简单的窗格和发动机系列导航,取代嵌套卡片和滚动区域;
2、Linux 源代码启动器现在能在 libxdo 和 GStreamer 音频插件缺失前发现它们,防止它们导致链接错误或中止的空白 WebKit 渲染器;
3、语音输入现在从快捷方式传输到最终交付的单一原生输出会话,仅在未动过时恢复文本、HTML、图片或文件列表剪贴板,除非明确启用当前焦点插入,否则保持Wayland的复制安全,并且仅通过已安装的本地ASR模型;
4、后端会立即绑定端口并实时报告启动进度——用步骤回答503,新的端点会列出每一步,同时PyTorch、API路由和数据库迁移在后台加载,所以“从步骤X开始”绝不会被误认为“死了”;桌面溅水器会讲述每一步;
5、捆绑的 Rust 回环侧车可展示口述启动/停止/切换、聚焦输出会话、发现和 JSON-RPC;后端增加了版本化的流式事件和无依赖的CLI桥,用于Herdr、编码代理、编辑器、桌面应用和TUIs;
6、无头的 NVIDIA 和 ROCm 机器现在可以作为仅限工作者的 Docker Compose 服务加入,无需公开的界面和持久协议 v2 注册;重新连接前将两台机器一起更新;
7、每个桌面操作系统(macOS/Linux/WSL)或(Windows)均可实现一命令安装——URL为每个平台提供正确的脚本,Windows则获得源安装程序()和3操作系统CI烟雾;
8、配音表中的逐行字幕管理:台词结束时间可与起始一同编辑(输入时间并拖拽时间线边缘现在路径相同),行与前一行及下一行合并(),且可以在任意行后插入新行;
9、CI现在对热路径强制执行性能回归预算——运算计数测试将流式TTS固定为每句一个合成,缓存的dub混音为零重合成;快速路径保护在启用时不支持重新解码和⌈N/W⌉本地批处理调用。






共有 0条评论