在数字内容泛滥的今天,我们总被各种云端 AI 工具裹挟,声音数据像隐私一样被悄悄上传到不知名的服务器,那种对创作失去掌控的感觉实在让人不安。VoiceStudio 的出现就像是在嘈杂的数字世界里递来了一副降噪耳机,它把整个音频工作室搬到了你的硬盘里,彻底打破了“免费就要交智商税”的魔咒。这不仅仅是一个软件,更像是一位住在本地、绝不窥探你隐私的沉默伙伴。
最打动我的不是它能一键克隆声音,而是那种“数据主权”带来的踏实感。想象一下,你精心录制的独特嗓音,不再变成别人训练模型的养料,而是永远沉睡在你自己的机器里,随时待命为你服务。它把零样本克隆、视频自动配音甚至有声书制作这些原本需要拼凑多个插件的功能,像搭积木一样整合在一起,这种“一站式”的本地化体验,让创作者终于能挺直腰杆说话。
当然,生活不是只有技术狂欢,软件也有它的脾气。比如它对录音素材的纯净度要求极高,一段带着背景音乐的杂音可能会让克隆效果大打折扣,这其实是在提醒我们:再强大的 AI 也离不开人类对原始素材的敬畏。它支持多种引擎切换,甚至能接入 Cursor 等开发工具,这种开放性既给了新手试错的空间,也给极客留下了无限改装的可能。在这个人人都在追求“一键生成”的时代,VoiceStudio 选择了一条更笨拙但更诚实的路——把控制权交还给你,让每一次声音的诞生都真正属于你自己,而不是算法的随机产物。
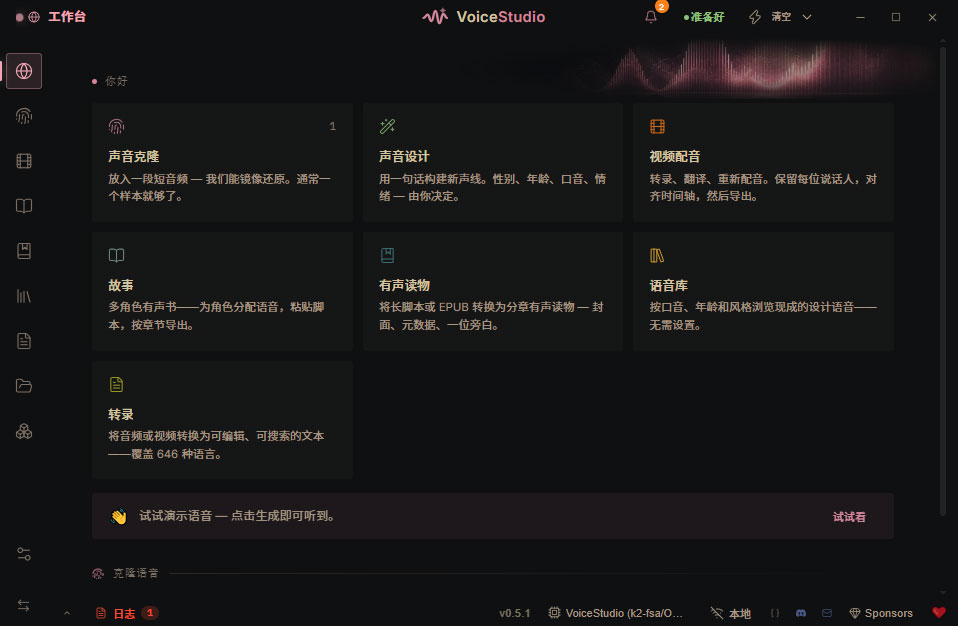
1、语音克隆(零样本克隆)上传5~30 秒干净音频,即可生成可复用音色,支持该音色跨多语种朗读。
法律提醒:克隆他人声音,必须取得本人授权,禁止未经许可盗用他人音色。
2、AI 声音设计用自然语言文字描述凭空创造不存在的虚拟音色,例如:中年低沉纪录片男声、温柔故事旁白女声。
3、视频自动配音(Dubbing)导入视频,自动人声分离、语音转写、翻译、重新合成配音,自动对齐时间轴;支持批量视频翻译配音,适合短视频本地化。
4、语音转写 + 实时听写内置悬浮听写窗口,麦克风实时转文字;也可以批量对音频 / 视频做字幕转录,内置 11 种语音识别引擎。
5、有声书 & 多角色广播剧制作多角色音色分配、分段生成旁白与对话,批量长文本处理,一键导出完整音频。
6、引擎自由切换 + 本地 API/MCP内置 16 套 TTS 引擎(默认 OmniVoice,可切换 CosyVoice、GPT-SoVITS 等),提供 OpenAI 兼容格式本地 API 与 MCP 接口,可被 Cursor、Claude Code、AI 智能体调用,接入自动化工作流。
一、打开voicestudio软件,首页点击 Voice Clone 卡片。工作台分三块:左侧是已克隆声音列表,中间是文本区,右侧是素材区。手边没有录音?点提示条里的 Try the demo voice,先拿内置示例声音把流程走一遍。
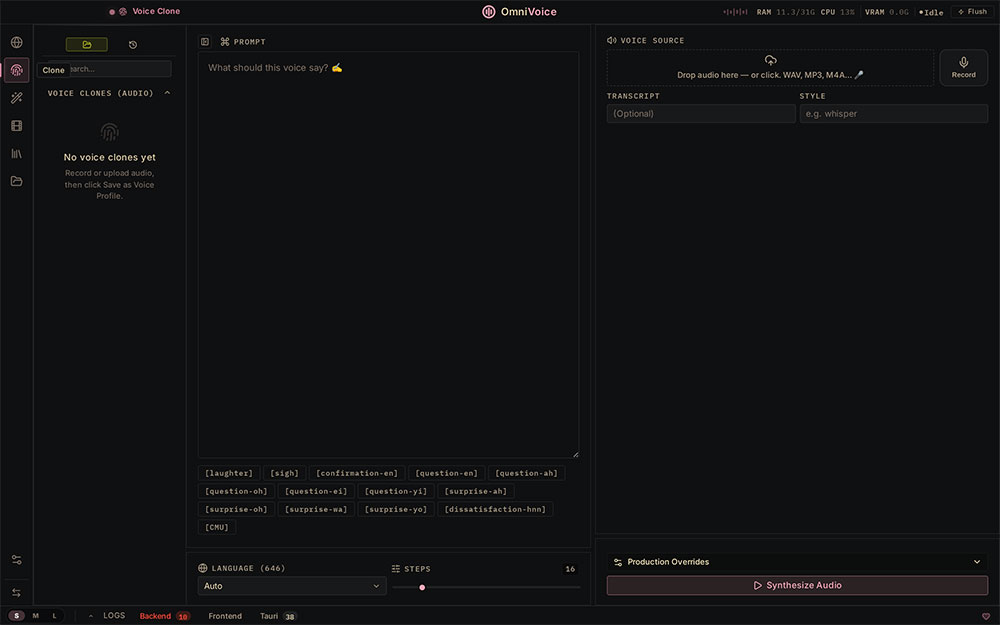
二、上传参考录音或现场录音 把 WAV / MP3 / M4A 文件拖进右侧 Voice Source 区域,或点 Record 直接录一段。克隆效果直接取决于这段素材,挑选标准很简单:
1、干净单人录音,无背景音乐
2、3 秒就够,5~15 秒更稳定
3、混响重、多人同说、带 BGM 的片段
三、输入文本并合成 在中间 Prompt 文本框输入要说的内容;底部语言选择器保持 Auto(或手动指定);拖动 Steps 滑杆调整精细度(默认 16);最后点 Synthesize Audio。
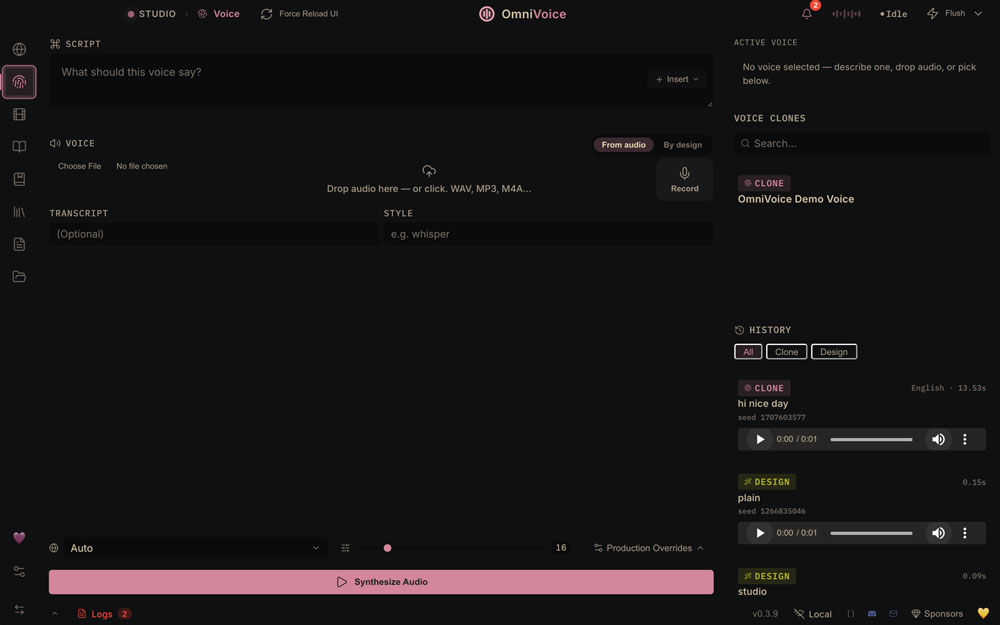
四、回放并确认 右侧 History 区域会出现一条带播放条的新记录,点开播放——这就是用你的音色说出的文字。成功克隆的声音会自动进入左侧 Voice Clones 列表,之后随时复用。
1、本地语音克隆
VoiceStudio 最实用的功能之一是零样本语音克隆。该工具可以使用简短的参考录音作为指导,生成新的语音内容。这样一来,你无需录制大量训练数据集,就能重现特定的说话风格。
这一过程对旁白、创意项目、演示和一致性语音制作尤其有帮助。由于主要创作流程保留在你的硬件上,你对参考片段和生成音频拥有更大的控制权。
2、自定义语音设计
有时你可能完全没有语音样本。在这种情况下,软件提供了语音设计控制功能,让你可以描述所需的说话人特征。你可以定义年龄、口音、音高、说话风格、语调和表达方式等细节。
这种方法为创作者在制作角色、旁白、教育语音或演示音频时提供了更多自由。你无需从固定的说话人列表中挑选,而是可以通过文字指令塑造结果,并不断尝试,直到表达方式符合项目需求。
3、视频配音工作流程
该工具还提供了完整的视频配音工作流程。它可以转录语音内容、翻译对话、保留不同说话人、生成替换语音,并导出完成的视频。
当视频中包含多个人物时,说话人保留功能尤其有价值。系统不会把每一行都当作来自同一个旁白者,而是在配音过程中维持说话人分配。这使得翻译后的视频看起来更有条理、更自然。
对于处理教程、采访、教育材料或多语言内容的创作者来说,这一集成工作流程可以减少手动编辑。
4、故事与有声书制作
长篇音频项目很容易变得难以管理,尤其是当它们包含许多章节和多种声音时。该软件包含故事和有声书功能,让你可以准备多 voice 脚本并分别渲染章节。
它还可以导入EPUB和PDF材料,使现有文字内容更容易转换为语音音频。基于章节的渲染有助于组织大型制作,而M4B导出则为完成的有声书项目提供了方便的格式。
这些工具共同作用,让长篇旁白不再像是管理数百个单独文件,而更像是处理一个有组织的书籍项目。
5、快速系统级听写
内置的听写小部件使语音转文字功能不再局限于主程序窗口。通过系统级快捷键,你可以在使用其他应用程序时开始说话,将语音转换为书面文字。
实时转录有助于笔记、文档、消息和其他写作任务。可选的本地LLM清理功能还可以改善原始听写文本。在支持的情况下,它可以将粗糙的口语短语转换为更整洁的书面表达,同时保持本地处理。
6、人声隔离与说话人检测
录音并不总是干净的。背景音乐、噪音、重叠语音和多个说话人都会使转录或配音变得更加困难。该软件通过专门的音频处理技术来解决这些问题。
Demucs支持可以将语音与背景音频分离,这在准备对话以进行进一步处理时非常有用。Pyannote和WhisperX集成可以处理说话人分离,帮助系统确定录音中不同时间点是谁在说话。
这些功能共同改善了采访、对话、播客、会议和其他多说话人录音的组织性。
7、批处理与文件夹监控
处理单个文件很简单,但大量文件可能会变得重复。内置批处理队列让你可以添加许多音频或视频任务,并按顺序进行处理。每个任务都可以显示自己的进度,因此你可以看到正在运行、已完成或仍在等待的任务。
该工具还可以监控本地文件夹中新添加的视频。这对于重复工作流程很有用,因为放入所选文件夹的文件可以被自动拾取处理,无需每次手动设置。
8、灵活的模型管理
不同的任务需要不同的AI模型,因此软件包含一个模型目录来管理它们。用户可以安装、移除、选择和路由用于文本转语音、自动语音识别和本地语言处理的模型。
这种方法不会把你锁定在单一引擎上,而是让你对如何处理单个任务拥有更多控制权。你可以根据硬件和项目需求,为语音创建、转录或语言清理选择合适的模型。
基于注册表的TTS、ASR和插件接口也使平台具有可扩展性。你可以添加新引擎和集成,而无需重新设计整个工作流程。
9、自动硬件检测
AI音频工作负载可能因所选模型和计算机硬件而有很大差异。该工具会自动检测并路由到CUDA、ROCm、MPS和CPU处理,并对各个引擎进行检查。
这有助于程序选择合适的处理路径,而不是期望每个用户手动配置硬件。具有兼容加速的系统可以使用它,而当专用加速不可用时,CPU路由提供了替代方案。
10、AI水印与MCP支持
生成的音频可以通过AudioSeal技术包含AI水印。该平台支持嵌入和检测,因此你可以识别包含受支持水印的音频。
对于希望将语音功能与兼容MCP客户端连接的用户,还包含一个MCP服务器。通过这个接口,合成和转录工具可以成为更大AI辅助工作流程的一部分,而不再局限于主应用程序。
11、隐私、诊断与可扩展性
本地优先设计是该软件最强大的功能之一。核心创作任务保留在你的机器上,而需要网络访问的功能则作为明确的选项呈现。这让用户可以更清楚地控制何时涉及外部服务。
内置诊断也使故障排除更加容易。自检可以帮助识别问题,而错误日志和日志文件提供了有用的技术细节。经过清理的支持包可以收集故障排除信息,同时减少不必要敏感数据。
其插件友好结构为开发者和高级用户提供了随时间扩展平台的空间。结果是一个可以随着新语音引擎、转录模型和支持工具而成长的系统。
一、创建声音
1、克隆声音
从简短、清晰的录音中生成语音。
2、设计声音
描述并优化声音。
3、使用语音画廊
预览语音并将其发送到工作区。
二、制作生产
1、为视频配音
转录、翻译、配音、生成、导出。
2、创作一个多声部故事
拆分剧本并分配角色。
3、创建有声书
导入书籍,规划章节,渲染长篇音频。
4、使用语音输入
捕获语音并保留本地转录历史记录。
操作系统:Windows 11 / 10
处理器:最低1 GHz处理器(推荐2.4 GHz)
内存:2GB(推荐4GB或更多)
可用硬盘空间:推荐500MB或更多
v0.5.6版本
一、亮点
1、使用保存的语音进行问候来接听 Twilio 电话;默认关闭,带有本地电话质量测试
2、Claude Code、Cursor、Codex CLI 和 OpenAI Agents SDK 已连接到 VoiceStudio 并正常工作
3、替换已保存克隆的参考样本,并从 OmniVoice 中克隆长度超过 20 秒的参考
4、长音频书章节在 8 GB GPU 上完成,并能承受断电或数据文件夹移动
5、马拉雅拉姆语数字、章节提示表和没有语音标记标签的字幕
二、已更改
Voice Clone 说出活动引擎使用了多长的参考时间,而不是要求你缩短到 15 秒
三、已添加
1、编辑已保存的语音克隆的参考样本:播放它,通过上传或录制替换它,并保存回同一语音
2、以保存的语音接听 Twilio 电话:默认关闭,签名 Webhook 和一次性流令牌,带有本地电话质量测试
3、马拉雅拉姆语配音和有声读物会用马拉雅拉姆语说出数字、百分比和小数,而不是读出原始数字
4、在故事或有声书渲染完成后,下载一个章节提示表(HH:MM:SSTitle)——时间戳与 M4B 的嵌入式章节相匹配,并提供MP3便携式章节
5、OpenAI Agents 集成页面提供了一个可复制的代码片段,该代码片段在 VoiceStudio上运行 Agents SDK 语音管道
6、OpenAI兼容的API添加了GET /v1/models和POST /v1/audio/translations(多语言Whisper模型;拒绝turbo模型)
7、语音请求接受 stream_format (audio 或 sse) 和 OpenAI's {"id": ...} 语音对象
8、转录通过language, prompt和temperature传递给 Whisper 引擎,并返回words带有timestamp_granularities[]=word
9、集成:可复制的 Codex CLI (config.toml)、任何 MCP 客户端(HTTP 或 stdio)、VoiceStudio API (curl 和 OpenAI SDK) 以及 Docker/GHCR
四、已修复
1、粘贴和导入的字幕不再识别卡拉OK标签,未更改的WebVTT和SubRip导出文件会保留原始字幕标记
2、保存了声音并上传了超过20秒的音频,在OmniVoice上重新克隆;最佳片段会自动挑选
3、VoxCPM2 不再将一个有上限的参考与整个片段的文本配对
4、说话人分割使用 Lightning 2.6.6,该版本阻止了来自恶意检查点的代码执行
5、在 8 GB GPU 上,长篇有声书章节在渲染时不再超时,并且超时章节会在当前分块后停止使用 GPU
6、在 Windows 上,重置连接不再让后端保持运行但无法访问
7、官方openai SDK 和 OpenAI Agents SDK 保持不变:gpt-4o-mini-tts并且当前 OpenAI 的语音名称不再因“未知模型”而失败
8、OpenAI instructions现在能够被语音引擎识别,而不是被忽略;OmniVoice 使用其中的语音设计标签
9、语音 pcm 为 24 kHz,正如 OpenAI 所指定的;aac并且 opus 返回真实的 AAC 和 Opus,而缺少编码器则是一个明显的错误,而不是一个标签错误的 WAV
10、转录报告会报告检测到的语言,而不是总是显示英语,并且verbose_json分段遵循 OpenAI 的模式
11、OpenAI兼容的路由返回OpenAI格式的错误,对于无效请求返回400
12、渲染的有声书章节在数据文件夹移动后仍可重用,并且关机不再清空恢复点或损坏章节音频
13、一个音频书章节缓存未命中现在会记录自缓存渲染以来哪些输入发生了变化
14、MCP 客户端指向 /mcp 在 Docker 上连接并从源构建,而不是获取 HTTP 405
15、MCP 工具和backend.speech_client 遵循一个后端,使用OMNIVOICE_PORT 而不是假设端口 3900
16、集成卡片显示真实能力:“支持 VoiceStudio”仅在存在设置时有效,其他地方均为“外部链接”







共有 0条评论