v2.1.0
最近手头攒了不少素材,正愁一个个去扒视频太费时间,直到挖到了这款叫 VidBee 的电脑端神器,感觉像是给数字囤积癖开了个外挂。它最绝的地方在于把“下载”和“理解”这两件事强行绑在了一起,以前咱们下完视频还得切出去转字幕、听录音写稿子,现在直接粘贴链接就能搞定,支持一千多个主流站点,哪怕那种高冷的 8K 画质也能顺手抓下来,连弹幕和字幕都同步导出,这效率简直是把时间从指缝里抢回来。更让我惊喜的是它内置的 Whisper 语音识别引擎,不管你是看外语片还是听播客,它能自动区分说话人、生成带时间戳的文稿,甚至点击文字就能跳转回视频对应片段,这种“所见即所得”的交互逻辑,让原本枯燥的转录工作变成了像翻书一样自然。不过用着也得有点脑子,比如订阅功能虽然强大,但要是遇到 Cloudflare 保护或者 RSS 源格式不对,软件就会傻眼,这时候就得自己折腾一下公共实例或者检查关键词过滤,毕竟工具再智能也替代不了咱们对网络环境的判断。最近 v2.1.0 更新把文稿直接整合进下载列表,还能批量删除,这种细节上的打磨说明开发者真的懂用户痛点,不再只是冷冰冰地搬运数据,而是开始思考如何管理这些数字资产了。
1、下载
排队观看来自1000+个网站的视频和音频。格式选择器、播放列表、一键操作、Cookie、日志。
2、转录
本地语音转文本,100+语言、说话者、搜索、导出、离线模型。
3、AI提示
内置和自定义提示,许多服务提供商(云端或本地)共享图片。
4、订阅
按订阅源文件夹、关键词筛选、仅限最新和手动排队。
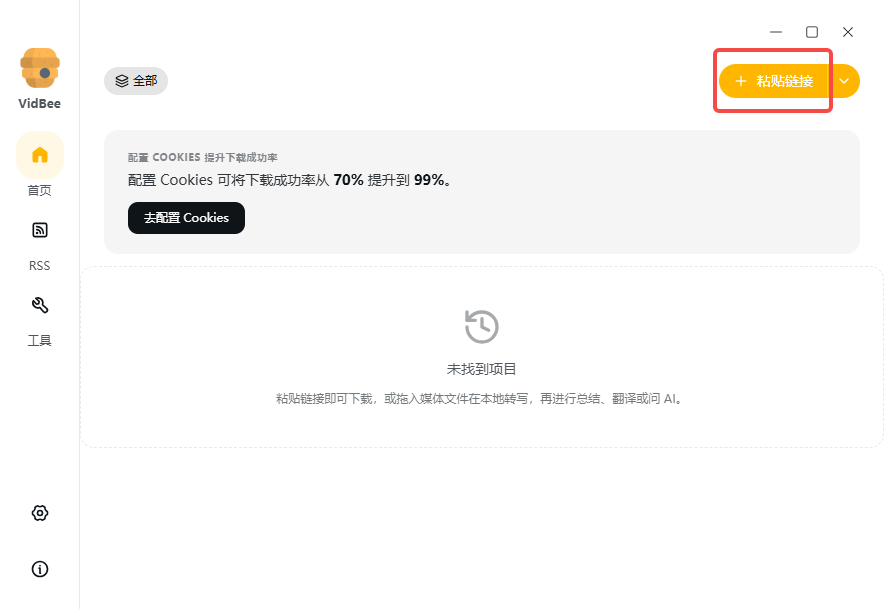
1、点击右上角的【链接粘贴】按钮,进入视频链接输入界面;
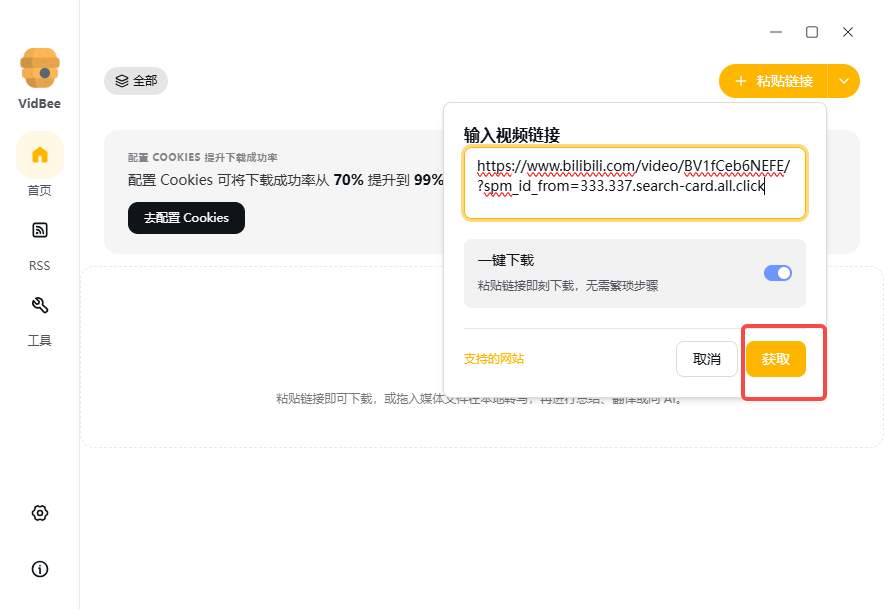
2、将视频链接粘贴至解析框中,然后点击【获取】;
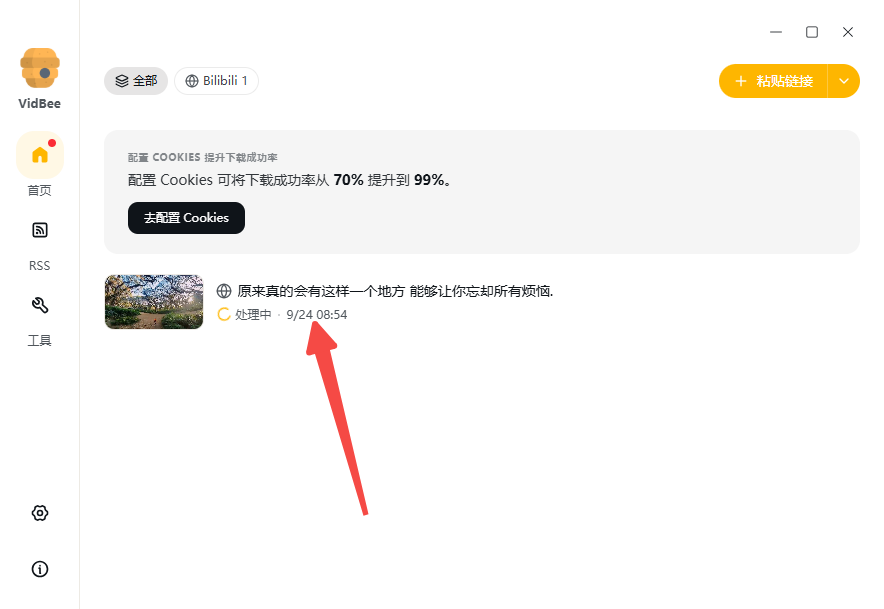
3、软件会自动解析链接并获取视频信息,稍后开始下载视频;
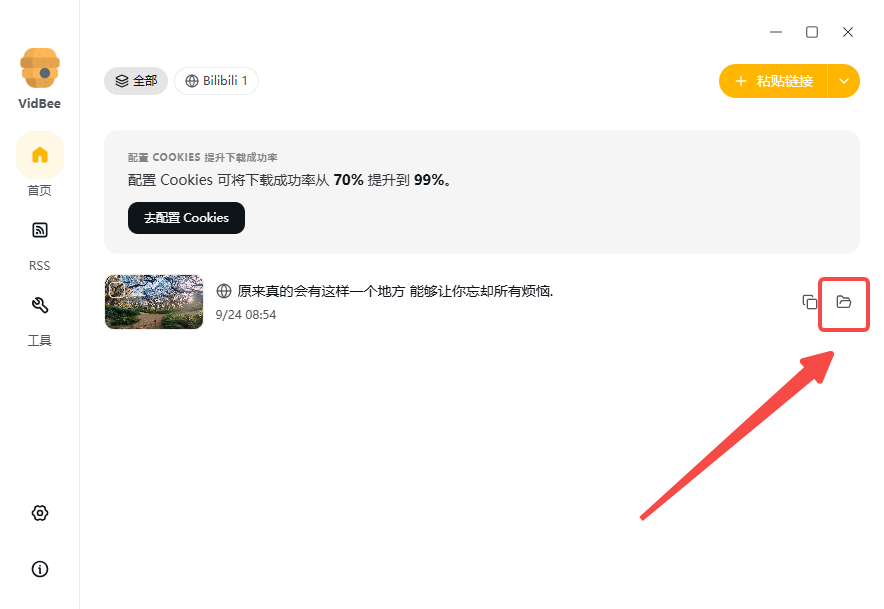
4、下载完成后,点击右侧的文件夹图标,即可打开视频保存目录,查看已下载的视频文件;
5、以上就是VidBee电脑版下载视频的操作教程。
Q1、为什么订阅会保存但不会排队新下载?
A:先检查以下情况:
※确认订阅源URL在浏览器中打开并返回RSS或Atom XML。
※如果你正在使用,建议切换到公共或自托管的RSSHub实例。官方实例由Cloudflare保护,VidBee无法直接读取。
※确保订阅已启用。
※请查看任何关键词过滤器。如果没有新物品匹配,就不会有任何物品排队。
※如果只启用了最新视频下载,VidBee只会排队最新的未显示内容。
Q2、为什么VidBee能从浏览器打开但无法启动下载?
A:这通常意味着链接已打开,但页面URL未以预期格式到达VidBee。
※确保浏览器允许外部应用提示。
※确认页面或扩展是否传递了带有URL编码的视频链接。
※更新 VidBee 后再试,因为旧版本可能与最新的浏览器行为不匹配。
Q3、“频道目前未上线”或“找不到视频”是什么意思?
A:这些消息通常描述的是源页面,而不是 VidBee 设置问题。
※频道目前不在线意味着流的URL指向一个目前离线的频道。
※找不到视频通常意味着帖子没有可下载的媒体,媒体已被移除,或者帖子格式发生了变化。
※在浏览器中打开页面确认媒体仍然可用。
v2.1.0版本
1、最新动态
编辑文字说明:添加一行、更改文字或删除一行或多行。
文字稿现在出现在下载列表中,因此视频和文字记录可以集中管理。
一次选择多个下载下载来删除它们。
2、改进
按网站筛选下载列表,并使用平台图标,使每个来源更容易识别。
长标题滚动,保持全名清晰可读。
没有音轨的文件会显示清晰的信息,而不是默默失败。


共有 0条评论